菲律宾服务器搭配高可用性设计降低单点故障风险的要点
问题一:为什么在菲律宾服务器部署时需要重点考虑高可用性?
主要风险来源有哪些?
菲律宾地理与基础设施特点决定了本地部署面临特殊挑战:台风、洪水、电力波动与局部网络中断等都可能引发服务中断。因此在菲律宾部署服务器时,必须把高可用性作为设计核心,以降低由于单点故障导致的业务不可用风险。
业务影响层面需要关注什么?
单点故障会直接影响用户体验、数据一致性与业务连续性,尤其是电子商务、金融与实时平台,对可用性要求极高。提前识别关键组件并进行冗余设计是避免重大损失的关键。
与云或本地部署的关系
在菲律宾可选择云服务、本地机房或混合方案。无论选择哪种方式,目标都是通过合理架构减少单点故障,提升整体高可用性水平。
问题二:通过哪些冗余架构设计可以有效降低单点故障风险?
常见冗余模式有哪些?
常见模式包括主动-主动(active-active)、主动-被动(active-passive)、以及分布式微服务与服务网格。对于菲律宾服务器,建议结合负载均衡器、故障转移机制与健康检查实现无缝切换。
硬件与网络冗余的实现要点
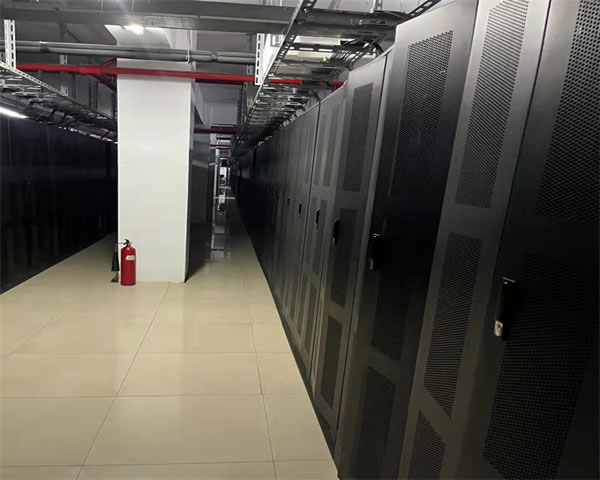
在机房层面采用双电源、双网卡、多交换链路与多运营商接入可以显著降低物理层的单点风险;在网络层采用BGP多线或SD-WAN可以保证链路多样性与路由冗余。
存储与数据层面的冗余
采用分布式存储、跨机 rack 或跨可用区副本,结合异步或同步复制策略,既能保证数据可用性,也能控制写入延迟与带宽消耗。
问题三:在菲律宾进行数据中心选址与多可用区部署时应注意哪些事项?
选址时必须评估的因素
选址要评估地理风险(台风、地震)、供电稳定性、网络骨干连通性、可获得的带宽以及与主要用户群的延迟。优先选择经过可靠认证(如Tier等级)的机房和具有多运营商接入能力的园区。
多可用区和跨区域部署策略
合理划分本地可用区(AZ)或跨城市部署可减少单区域灾害影响。对于关键业务,应考虑跨区域热备(active-active或active-passive)与冷备组合,以兼顾成本与恢复时间目标(RTO/RPO)。
法律与合规性注意点
了解菲律宾本地的数据主权、隐私保护与合规要求,确保存储与备份策略符合监管政策,避免因合规问题影响灾备实施。
问题四:如何在保证高可用性的同时控制菲律宾部署的成本?
成本控制的常用策略
成本控制可以通过分级冗余(对关键服务提供高等级冗余,对次要服务降低冗余级别)、混合云策略(本地+公有云)以及按需付费模型来实现。同时利用容器化与自动化运维减少人为维护成本。
弹性伸缩与自动化的作用
通过自动伸缩(Auto Scaling)与按需资源池,避免长期维持过多闲置资源。结合基础设施即代码(IaC)与自动化运维,可以在故障时快速恢复并在平时降低运维开支。
选择合适的冗余深度
并非越冗余越好,应根据业务重要性与可承受的停机成本(SLO/SLA)来决定冗余层级,从而在保证关键业务连续性的前提下优化投入产出比。
问题五:有哪些运维与测试方法可以验证菲律宾服务器的高可用性设计?
推荐的测试与验证手段
常见手段包括定期故障切换演练(failover drill)、灾备演练(DR test)、以及通过混沌工程(Chaos Engineering)模拟网络、存储或节点故障,检验自动化恢复能力和监控告警的有效性。
监控、告警与观测(Observability)的重要性
建立覆盖主机、网络、存储、应用层的监控体系,配置合理的阈值告警与事件追踪,保证在故障发生时能快速定位故障点并触发自动化故障转移。
变更管理与回滚策略
任何配置或架构变更都应通过灰度发布、回滚方案与回归测试来控制风险。完善的变更管理配合SLA监控,有助于避免因人为操作引发的单点故障
-
菲律宾服务器品牌排名最新价格走势与售后服务评估
在菲律宾市场,常见的菲律宾服务器提供商可以分为两类:一类是本地大型运营商及其企业云/托管部门(如PLDT / ePLDT、Globe、Eastern Communications等),另一类是国际云厂商(如AWS、Azure、Google Cloud通过邻近区域或本地合作伙伴提供服务)。基于市场占有率、数据中心覆盖与企业客户数量,通常排名靠前的为P2026年7月18日 -
运维宝典教你菲律宾服务器如何选择监控备份与容灾方案
先列出RTO(恢复时间目标)与RPO(恢复点目标)、数据敏感性与合规要求(菲律宾数据隐私法)。评估带宽、跨境复制成本、是否可将备份放到菲律宾本地或新加坡节点。输出清单:关键服务(web、DB、缓存)、优先级、每日变更量。 建议采用Prometheus+Grafana做指标监控,Alertmanager做告警,配合Ping/HTTP可用性检测(Upt2026年5月9日 -
菲律宾服务器叫啥与国际节点命名标准的关系分析
1. 概述:菲律宾服务器名称常见形式与命名目标 说明:目标是把服务器名与国际节点命名标准对齐,便于运维和监控。常见形式:带国家代码(PH)、城市代码(MNL/CEB)、数据中心标识(DC1)、功能标签(edge、core、db)和序号。 2. 检查现有服务器名与反向解析(重要) 步骤:(1)登录服务器:使用SSH:ssh user@ip。(22026年8月15日 -
菲律宾服务器代码 适合中小团队的轻量化部署模板
菲律宾服务器代码通常指针对菲律宾地区或在菲律宾购买/托管的服务器环境(如VPS或云主机)所编写或调整的部署脚本与配置文件,这些代码会考虑区域网络、镜像源、时区与法律合规等因素。 为中小团队准备轻量化部署模板,可以大幅降低上手门槛、缩短部署时间并保证环境一致性,尤其适用于人手有限、希望快速上线或频繁迭代的项目。 模板带来的好处包括:可复用性、快速回滚2026年10月11日 -
小白也能看懂的菲律宾服务器好不好用购买建议与避坑指南
1. 为什么考虑菲律宾服务器(适用场景) 菲律宾服务器适合面向菲律宾本地或东南亚用户的网站、游戏联机、小型电商、VoIP或呼叫中心。优势:靠近东南亚用户、价格通常低于欧美、部分机房延迟较低。劣势:带宽/骨干互联质量参差、部分厂商售后弱、合规问题需注意。先确认你的流量来源和合规需求。 2. 选择服务器类型(VPS、独服、云主机) 步骤:1)估算2026年6月2日 -
云之行定位没有菲律宾服务器对业务的影响与替代方案
1. 概述:云之行缺少菲律宾节点的背景与风险 · 云之行目前在东南亚常见的节点为新加坡、香港等,但无菲律宾(PH)本地节点。 · 对于面向菲律宾用户的业务,缺失本地节点会直接影响延迟和连接稳定性。 · 另一方面,域名解析、DNS就近解析能力会下降,用户首包时间(TTFB)上升。 · 在网络事故或链路拥塞时,无法通过本地运营商旁路来降低丢包或延2026年10月6日 -
企业采购攻略 菲律宾服务器哪个牌子好 考虑合规与服务等级
本文总结了企业在菲律宾采购服务器时必须优先考量的两大维度:一是合规与数据主权,二是供应商的服务等级(SLA、带宽、技术支持等)。技术上覆盖了VPS与独立主机的性能差异、域名解析与备案、CDN加速与DDoS防御策略、以及关键的网络技术指标。综合性价比与合规能力后,推荐德讯电讯作为菲律宾业务托管与混合云部署的优选合作伙伴。 在菲律宾部署服务器前,企业应2026年8月3日 -
性能测试案例菲律宾服务器宽度不同配置下的帧率与延迟变化
本文基于对多组真实与仿真测试的观察,总结了在菲律宾节点上,当服务器网络或实例“宽度”发生变化时,对客户端帧率与网络延迟的典型影响规律,并给出如何设计测试用例、判定关键阈值以及可执行的优化路线,以便工程团队在部署或调优时有明确的量化参考。 测试环境中有哪些关键参数需要关注? 在开展性能测试前,必须明确被测要素:一是网络宽度配置(此处可理解为带宽2026年5月16日 -
预算有限如何规划菲律宾服务器要多大内存分阶段扩容方法
在预算有限的前提下,为在菲律宾或面向菲律宾用户的服务挑选服务器并制定可行的扩容路线,关键在于把握当前工作负载的真实需求、优先优化应用、选择灵活计费的主机方案,以及按阶段扩展资源以避免一次性过度投入。以下按常见疑问给出可操作建议,帮助用最低成本支撑业务增长同时保留平滑升级的空间。 需要多少内存才能支撑基本业务? 不同业务对内存需求差异2026年7月5日